
Karpathys Tipps, um LLM-Output zu verstehen, und das ASD-STE100-Cheat-Sheet, das den Standard falsch wiedergibt
Andrej Karpathys Stufenleiter zum Lesen von Modell-Output führt von kontrolliertem Englisch über Diagramme und HTML-Seiten bis zu Erklärvideos, jede Stufe leichter aufzunehmen als die vorige. Das Cheat-Sheet zu seinem Post ist eine saubere, selbstsichere Zusammenfassung von ASD-STE100, die eine Wörterbuchregel umkehrt, ein Verb zulässt, das der Standard ablehnt, und eine Empfehlung als Wörterbucheintrag ausgibt. Ein klareres Format kann einen Fehler aufdecken oder ihn glaubwürdiger machen; die nützliche Frage ist, was du mit jedem Format überprüfen kannst.
Am 2. Oktober hat Andrej Karpathy eine kurze Anleitung zu einem Problem gepostet, das die meisten von uns inzwischen täglich haben. Sie beginnt so:
We'll be spending a lot more time trying to understand the outputs of language models.
A few thoughts, tips & tricks:
Als ich den Post am 4. Oktober gesichert habe, stand er bei 6,4 Millionen Aufrufen. Auf diesen Einstieg folgt eine Leiter aus vier Ausgabeformaten, jede Stufe eingeleitet mit „But even better:“, und dazu ein Bild: eine einseitige Zusammenfassung von ASD-STE100 im Stil einer technischen Zeichnung. ASD-STE100 ist das kontrollierte Englisch, in dem Wartungshandbücher für Flugzeuge geschrieben werden.
Ich habe den Post gelesen, dann den Standard, den er empfiehlt, und dann das Bild mit dem Standard abgeglichen. Das Layout macht die Regeln leicht überfliegbar, das meiste stimmt, und drei Zeilen im Wörterbuchteil würden dem Leser etwas Falsches beibringen. Genau das ist am Ende der nützlichste Teil des ganzen Threads, denn es ist das Thema des Posts selbst, vorgeführt von seinem eigenen Anhang.
Was empfiehlt Karpathy, um LLM-Output zu verstehen?
Vier Formate, aufsteigend nach Anspruch. In seinen Worten, gekürzt:
Writing. Something I've had success with: Ask your LLM to explain something in ASD-STE100,
it's a controlled language specification originally developed for aerospace maintenance
documentation.
Diagrams / images. Instead of writing, ask your LLM to create a diagram. These can be a lot
easier to process, parse, and understand.
Web pages. Ask for output "in HTML" to get a beautiful, interactive webpage.
Explainer videos. The output format I am most bullish on is fully custom / bespoke explainer
videos generated on any arbitrary topic.
Für die Stufe Text macht er pragmatisch Abstriche: Manchmal bittet er um „80% of the way to ASD-STE100“, weil „the spec is quite stringent“. Für Video gibt er einen Beispiel-Prompt, „Create a 3b1b style video explainer on X. Use my ElevenLabs API key for audio narration“, und merkt an, dass du das Modell stattdessen auch nach „decent free alternatives that use your local compute“ suchen lassen kannst, also nach brauchbaren kostenlosen Alternativen, die auf deinem eigenen Rechner laufen.
Die eigentliche These steckt in der Zusammenfassung. Je mehr Arbeit Modelle übernehmen, desto mehr wandert unsere Arbeit nach oben in die Abstraktion: „a lot more of our work will rise up the abstractions into oversight and understanding.“ Weil Intelligenz und Code billig werden, „you can ask for large, custom, discardable software artifacts (e.g. web apps, video explainers) that would have never made sense to create before.“ In diese Richtung denkt er schon länger: Sein Jahresrückblick 2025 nannte Code bereits „discardable after single use“ und sagte, Modelle sollten in dem Format mit uns sprechen, das wir bevorzugen.
Der Richtung stimme ich zu. Im Rest dieses Textes geht es darum, was du mit jedem Format überprüfen kannst.
Was ist ASD-STE100, und warum sollte ein LLM darin schreiben?
ASD-STE100 ist Simplified Technical English, eine kontrollierte Sprache, die 1979 entstand. Damals verlangten europäische Airlines von den Flugzeugherstellern Wartungsunterlagen, die ein Mechaniker auch in einer Zweitsprache nicht missverstehen kann. Der erste Leitfaden erschien 1986. Gepflegt wird der Standard von ASD, dem europäischen Verband der Luft- und Raumfahrt- und Verteidigungsindustrie. Die aktuelle Fassung, Issue 9 vom 15. Januar 2025, hat ihn von einer Spezifikation zu einem internationalen Standard gemacht.
Er besteht aus zwei Teilen. Erstens die Schreibregeln: 53 davon in neun Abschnitten, zu Wörtern, Mehrwortsubstantiven, Verben, Sätzen, prozeduralem und beschreibendem Schreiben, Sicherheitshinweisen, Zeichensetzung und Schreibpraxis. Zweitens ein Wörterbuch mit rund 900 zugelassenen Wörtern, in der Regel mit je einer Bedeutung und einer Wortart, dazu rund 1.200 nicht zugelassene Wörter mit zugelassenen Alternativen. Autoren dürfen außerdem technische Substantive und technische Verben aus festgelegten Kategorien verwenden, STE ist also nicht auf diese 900 Wörter beschränkt. Die Grenzen, die meistens zitiert werden, gibt es wirklich: höchstens 20 Wörter in einem prozeduralen Satz und 25 in einem beschreibenden, sechs Sätze pro Absatz, drei Wörter in einem Mehrwortsubstantiv, eine Anweisung pro Satz, außer die Handlungen finden gleichzeitig statt, Aktiv, keine Semikolons.
Warum das zu einem Modell passt: Die Regeln entfernen genau die Gewohnheiten, die LLM-Prosa so ermüdend machen. Kein „it is imperative that“, kein „prior to commencing“, keine verschachtelten Nebensätze und eine klare Vorliebe dafür, zu sagen, wer was tut. Karpathys Punkt ist, dass Modelle den Stil gut kennen und das Ergebnis „a lot more readable“ ist. Und dass es menschlichen Lesern hilft, ist tatsächlich belegt: Eine Studie von 1996 mit 175 Technikern aus der Flugzeugwartung fand ein besseres Verständnis mit Simplified English, am stärksten bei den schwierigsten Arbeitskarten und bei Lesern, für die Englisch nicht die Muttersprache war.
Bevor du es nutzt, solltest du wissen, was du dir da ausleihst:
- Es ist kostenlos erhältlich, darf aber nicht frei weitergegeben werden. Du forderst ein Exemplar über die offizielle Download-Seite an; das Dokument ist urheberrechtlich durch ASD geschützt, die Vervielfältigung ist auf die Erlaubnisse im Copyright-Hinweis beschränkt.
- Die FAQ des Standards sagt, es „is not intended for general-purpose writing“, sei also nicht für allgemeines Schreiben gedacht, räumt aber ein, dass seine Prinzipien wie kurze Sätze und Aktiv sich gut übertragen lassen. Karpathys „80% of the way“ ist genau dieser Kompromiss.
- Es ist schwer, gut darin zu schreiben: „STE was created for the maximum benefit of the reader. This does not necessarily mean that it is simple to write.“
Karpathy hat das nicht angestoßen. Im Juli 2026 schwappte eine Welle von „lass das Modell in STE schreiben“-Skills über GitHub und Hacker News, zwei davon mit jeweils mehr als 3.000 Sternen. Sein Post hat das Thema vor ein viel größeres Publikum gebracht.
Gibt das ASD-STE100-Cheat-Sheet aus Karpathys Post den Standard richtig wieder?
Viele Details stimmen, und mehrere Einträge würden die falsche Regel beibringen. Das ist das Bild aus dem Post:
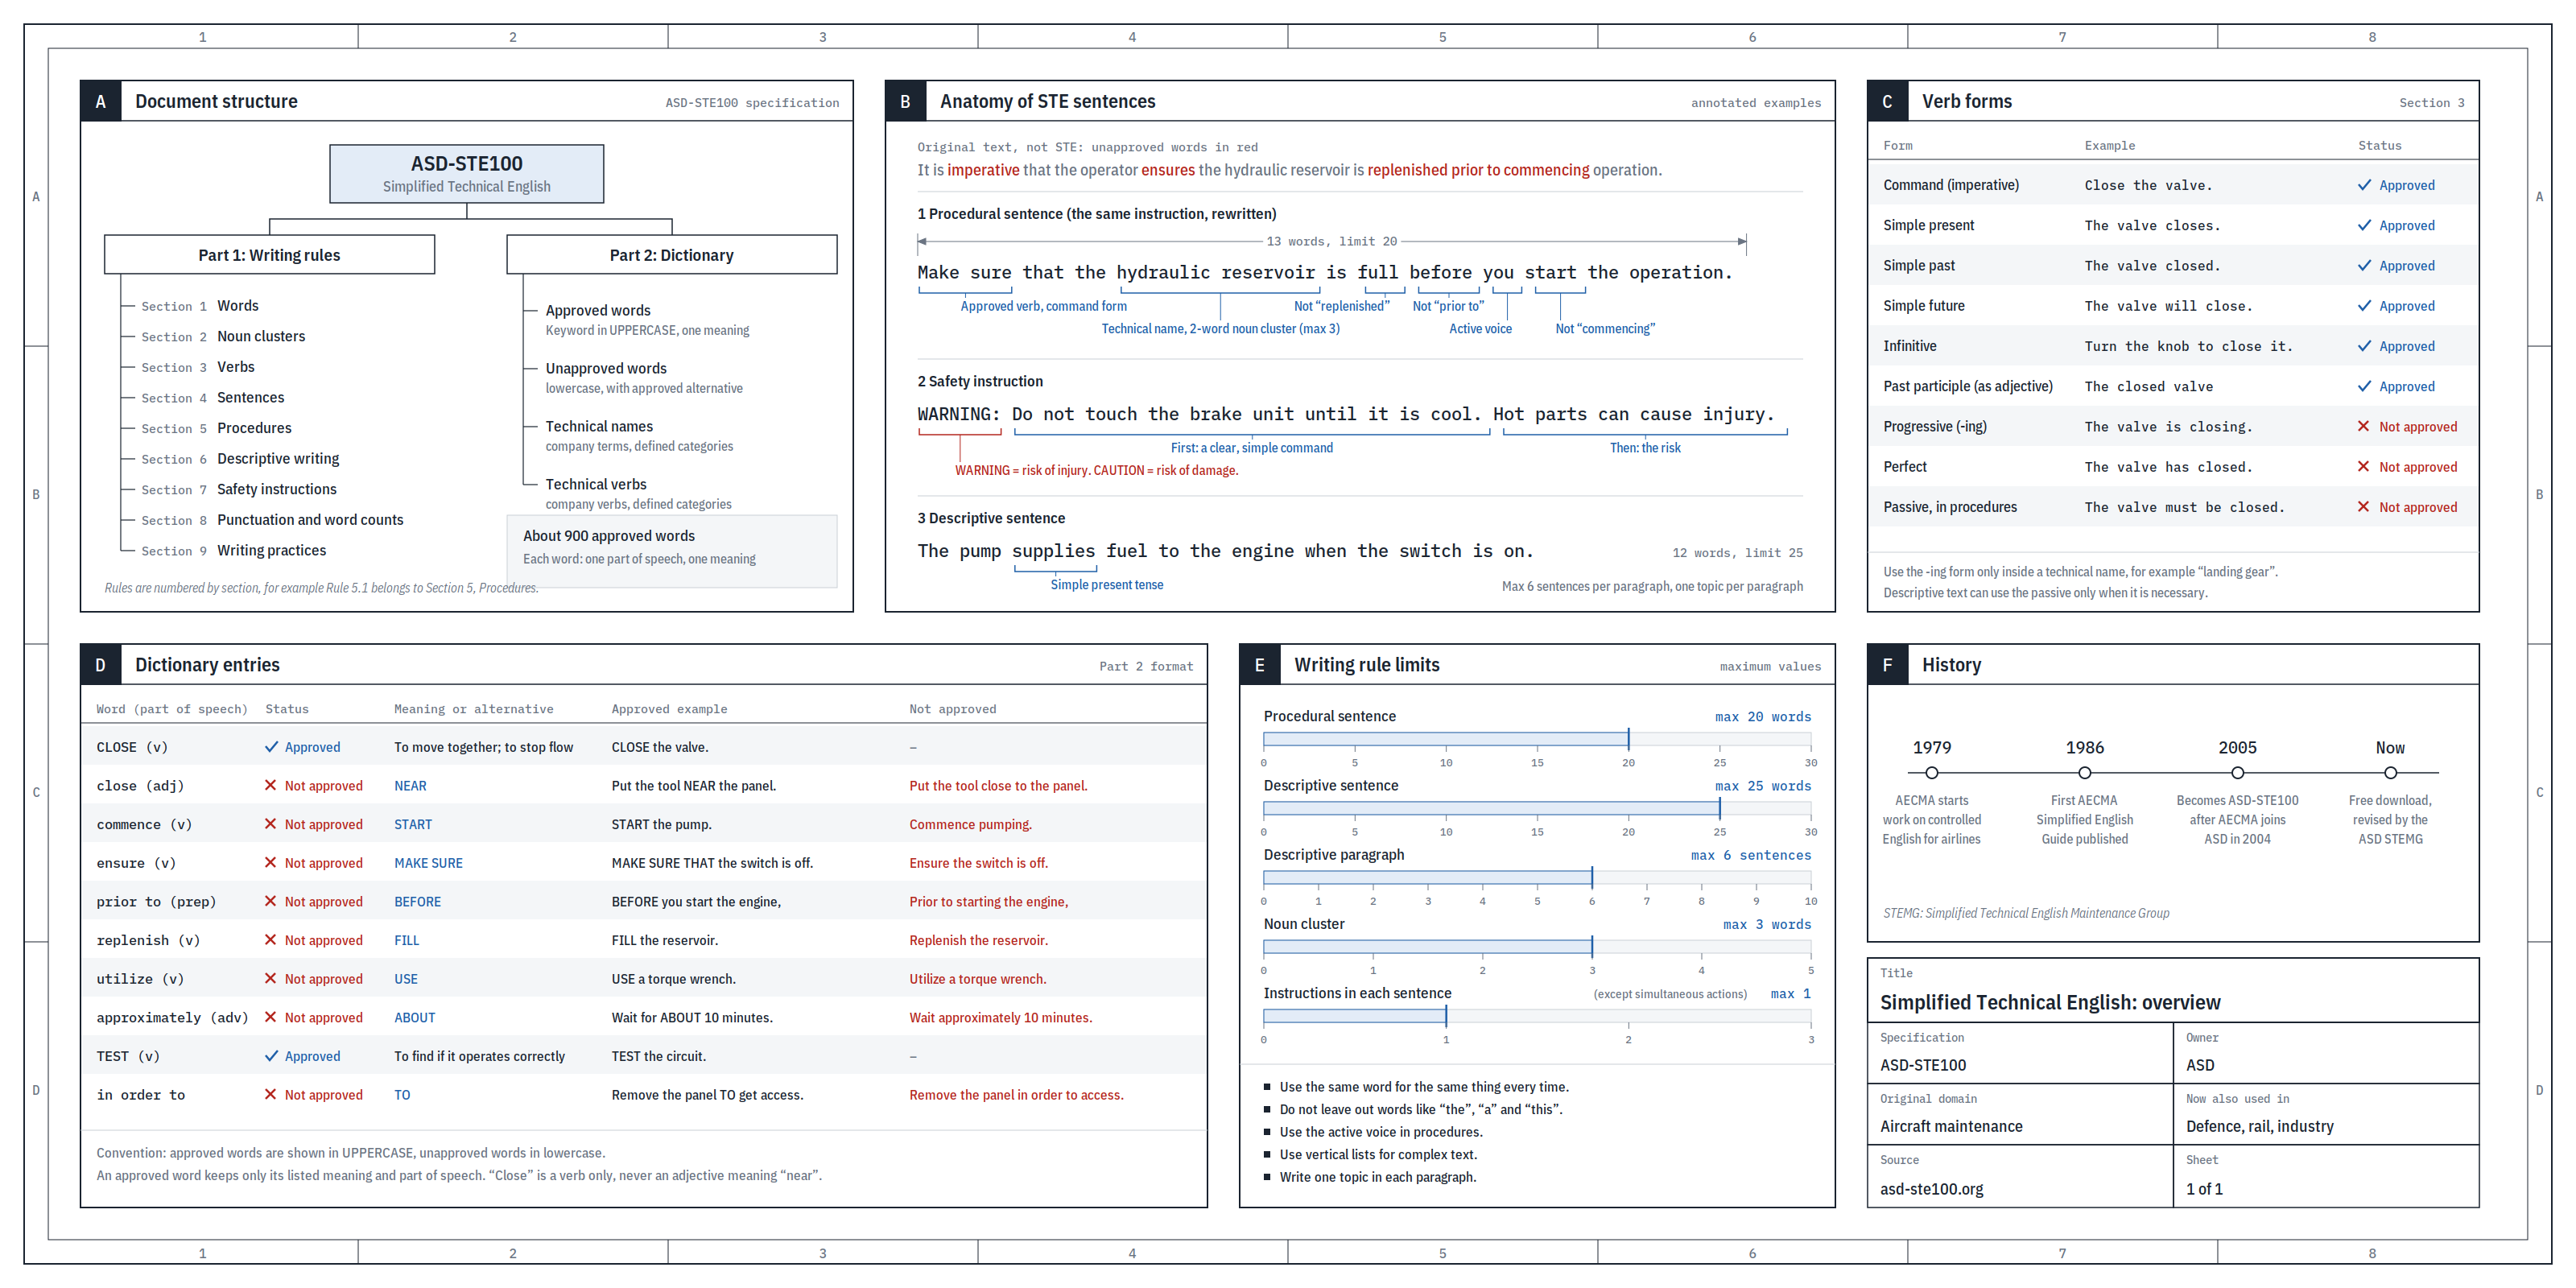
Bild aus Karpathys Post auf X vom 2. Oktober 2026, zur Besprechung wiedergegeben; wer es erstellt hat, ist nicht angegeben. Es ist keine Publikation von ASD.
Ich habe es Feld für Feld mit Issue 9 abgeglichen und, wo es sinnvoll war, mit Issue 8. Vieles stimmt: jede Zahlengrenze (20, 25, 6, 3, eine Anweisung pro Satz), die sechs zugelassenen Verbformen, der Aufbau aus zwei Teilen und neun Abschnitten, die Großschreibung für zugelassene Wörter und die Beispielsätze samt Wortzahl. Sieben der zehn Wörterbuchzeilen haben das richtige Wort und den richtigen Status. Ein müder Leser würde dem Blatt vertrauen, und meistens zu Recht.
Jetzt zum Wörterbuchfeld, wo es danebengeht:
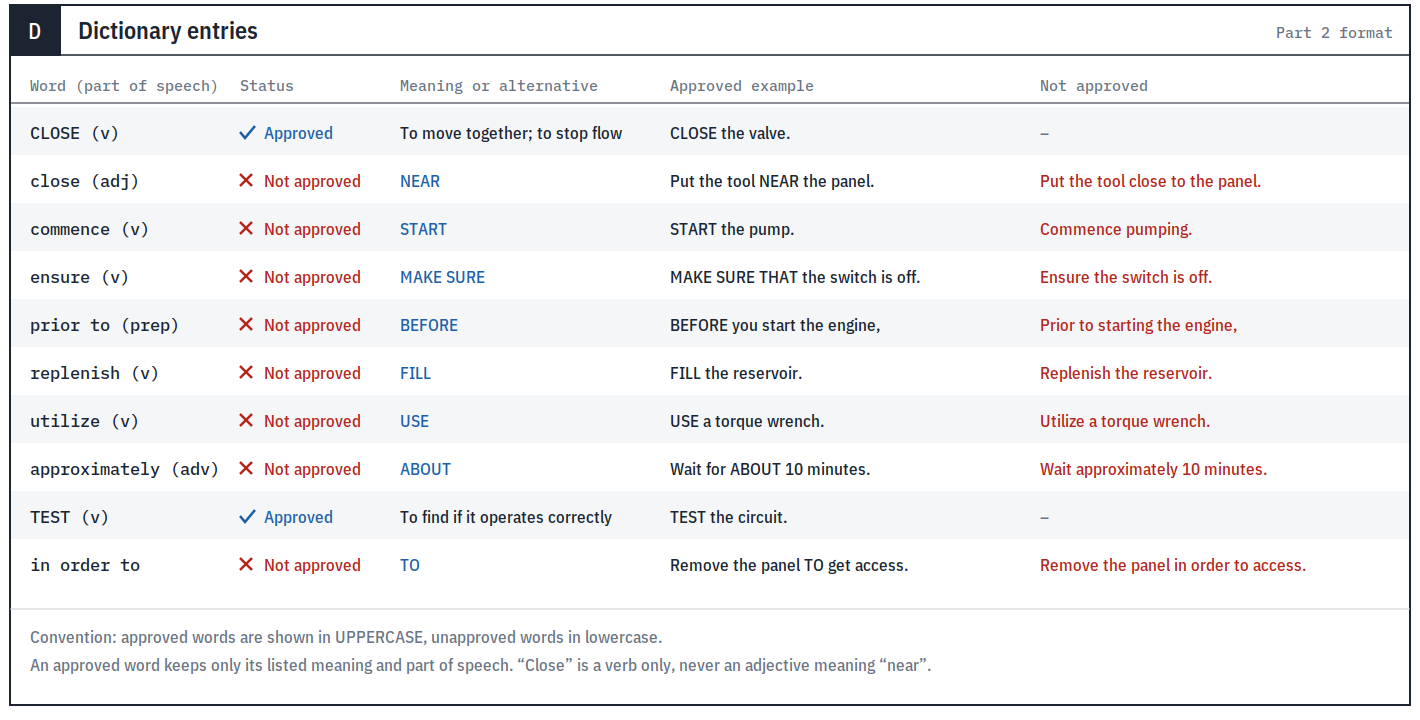
Ausschnitt aus demselben Bild.
- approximately ist zugelassen, und das Blatt behauptet das Gegenteil. Die Zeile markiert „approximately (adv)“ als nicht zugelassen und bietet stattdessen ABOUT an, mit „Wait for ABOUT 10 minutes“ als korrekter Form. Im Standard ist es genau umgekehrt. APPROXIMATELY ist ein zugelassenes Adverb mit der Bedeutung „almost correct or accurate“. ABOUT ist nur als Präposition zugelassen, mit der Bedeutung „concerned with“, und der Standard nutzt genau dieses Paar als Lehrbeispiel: „Drain about 2 liters of fuel from the tank“ ist sein Beispiel dafür, wie man es nicht schreiben soll. Das Blatt lehrt den Fehler, vor dem der Standard warnt.
- TEST ist kein zugelassenes Verb. Die Zeile markiert „TEST (v)“ als zugelassen, mit der Definition „To find if it operates correctly“, die ich im Standard nicht finden konnte. TEST ist nur als Substantiv zugelassen; das Beispiel des Standards lautet „DO A FUNCTIONAL TEST OF THE SOFTWARE“, mit „Functionally test the software“ als Variante, die man vermeiden soll. Jemand hat genau diese Regel im Juli auf Hacker News zitiert.
- Für „in order to“ habe ich keinen Eintrag gefunden. Die Verkürzung zu TO ist ein vernünftiger Rat und im Sinne des Standards, aber eine solche Zeile fand ich weder im Wörterbuch von Issue 9 noch in dem von Issue 8. Das Blatt präsentiert eine Empfehlung im Format eines Wörterbucheintrags.
Außerhalb des Wörterbuchs gibt es zwei weitere inhaltliche Probleme. Das Verbfeld sagt, beschreibender Text „can use the passive only when it is necessary“. Die Regel ist enger: In beschreibendem Text „you can use the passive voice only when the agent is unknown“, also nur, wenn der Handelnde unbekannt ist. „Wenn nötig“ ist eine Ermessensfrage, „wenn der Handelnde unbekannt ist“ ist ein Prüfkriterium. Und das Strukturfeld führt technische Namen und technische Verben als Inhalt des Wörterbuchs auf, während die FAQ klar sagt, dass das Wörterbuch sie nicht auflistet; es sind Kategorien, die in den Schreibregeln definiert sind.
Dazu kommt ein leiseres Signal, das sich durch das ganze Blatt zieht: Seine Terminologie stammt aus der Zeit vor Issue 9 und passt zu Issue 8. Es sagt „noun clusters“ (heute „multi-word nouns“), „technical name“ (heute „technical noun“), „Specification“ im Titelblock (heute ein Standard), und seine Zeitleiste endet vor der Änderung von 2025. Eine Abschnittsüberschrift, „Procedures“, passt zu keiner der beiden Ausgaben.
Der Post sagt nicht, wer das Bild gemacht hat oder wie, und egal woher es stammt, das Ergebnis ist dasselbe: brauchbare Zusammenfassungen neben falschen Wörterbuchratschlägen, in einem Layout, das beides gleich autoritativ aussehen lässt. Es wird bereits als Quelle verwendet. Ein Repository, das am Tag des Posts angelegt wurde, übernimmt seine Grenzwerte aus „Karpathy's sheet“ (die Grenzwerte sind zufällig der korrekte Teil). Und ein anderer STE-Skill, der im Juli geschrieben wurde, also vor dem Post, hat ein offenes Issue, das zwölf Zeilen auflistet, die zugelassene Wörter verbieten, approximately darunter. Maschinell erstellte STE-Worttabellen scheitern also unabhängig voneinander auf dieselbe Weise. Leser haben einen Teil davon bemerkt: Etwa 20 Stunden nach dem Post wies eine Antwort auf die Zeile approximately hin, indem sie eine Antwort von ChatGPT einfügte, und eine Referenzdatei auf GitHub dokumentierte denselben Fehler und die älteren Begriffe. Dass jemand auf die Zeile TEST, die Zeile „in order to“ oder die Umschreibung der Passivregel hingewiesen hätte, habe ich nicht gefunden.
Die Betreuer des Standards haben das kommen sehen. Im Juni 2026 haben sie ein White Paper zu STE und AI veröffentlicht, und die Download-Seite fasst es in zwei Sätzen zusammen, die ich über jeden AI-Styleguide stellen würde:
AI-generated text can appear clear, authoritative, and consistent with STE, even when it
does not correctly apply the rules and vocabulary of the standard. Plausibility must not
be confused with verified compliance.
Halten sich LLMs tatsächlich an ASD-STE100, wenn du sie darum bittest?
Nur locker, und sie glauben meist, sich besser daran zu halten, als sie es tun.
Jemand aus der technischen Redaktion, der genau hingeschaut hat, nennt das, was Modelle produzieren, „STE-flavored English, not STE“: Ohne Abgleich mit dem aktuellen Wörterbuch kann ein Modell den Stil imitieren und dabei die Vokabelregeln brechen. In den Antworten unter Karpathys Post berichtet jemand, dass drei aktuelle Modelle die Bitte „simply ignore“; andere sahen kaum einen Unterschied zwischen der STE-Antwort und der normalen. Auf Hacker News war im Juli eine wiederkehrende Meinung, dass die Regeltreue schnell abdriftet und nur ein Linter oder ein Commit-Hook sie hält.
Die Messungen sind dünn. Der STE-Skill mit den meisten Sternen warb damit, er „cuts slop 72.9%“; diese Zahl zählte Verstöße gegen die Linter-Regeln des Skills selbst, und in einem späteren Audit von Version 2.0.0 mit acht Szenarien stellte sein Autor fest, dass ein kurzer Prompt kürzere Antworten mit weniger Formatierungsfehlern lieferte. Das war keine Verständnisstudie, und das Projekt hat den Skill inzwischen neu gebaut. Lucian Ghinda hat einen kleinen, ausdrücklich informellen Test mit Code-Erklärungen gemacht: Bei Claude lieferte ein lockerer „simple technical English“-Prompt Antworten mit 8,5 % weniger der bewerteten Fakten als die Basisantwort, ein strikter ASD-STE100-Prompt Antworten mit 46,8 % weniger; bei Codex lagen die Verluste bei 43,3 % und 40,0 %. Vier Code-Beispiele, zwei Sessions. Nimm das als Warnung, dass bei der Vereinfachung Fakten verloren gehen können, nicht als Ranking. Zwei Preprints von 2026 zum Befolgen von Vorgaben finden, was man erwarten würde: Modelle überschätzen ihre eigene Regeltreue, und sie können eine Regel wiedergeben, während sie sie brechen.
Die praktische Schlussfolgerung ist dieselbe, die ich zu Prompts im Allgemeinen gezogen habe: Eine Stilregel in einem Prompt ist eine Bitte, keine Garantie. Wenn du wirklich STE brauchst, prüfe es außerhalb des Modells. Der Prosa-Linter Vale kann die Regeln abbilden, die du durchsetzen willst, und ersetzt damit auch „80%“ durch eine Liste, für die du dich entschieden hast. Ein Linter prüft die Regeln, die du konfiguriert hast; er bestätigt weder volle STE-Konformität noch, dass der Text stimmt.
Sind Diagramme besser als Text, um LLM-Output zu verstehen?
Larkin und Simon haben die Antwort in den Titel ihres Papers von 1987 gepackt: „Why a Diagram is (Sometimes) Worth Ten Thousand Words.“ Ein Diagramm mit denselben Informationen wie ein Text kann viel leichter zu nutzen sein, weil die Position die Zuordnung übernimmt, die ein Leser sonst im Kopf leisten müsste. Eine Metaanalyse von Cromley und Chen aus dem Jahr 2025 über 181 Studien zum multimedialen Lernen fand einen Gesamteffekt um 0,37, mit großer Streuung je nach Gestaltungsprinzip und Ergebnismaß; die Ergebnisse für Text plus Diagramm gehörten zu den konsistenteren, die für Animation deutlich weniger.
Zwei Vorbehalte, die speziell für Modelle gelten. Generierte Diagramme sind als Diagramme immer noch unzuverlässig: Benchmarks zu SVG, Mermaid und ähnlichen Formaten zeigen echte Lücken. Und ein Diagramm hat seine eigene Art zu übertreiben. Eine Antwort hat es gut auf den Punkt gebracht: Wenn du vereinfachst, schütze Wörter wie „wenn“, „außer“ und „noch nicht verifiziert“, denn ohne sie „a clearer sentence can become a stronger claim“, ein klarerer Satz kann zur stärkeren Behauptung werden. Für ein Diagramm gilt dasselbe: Ein fehlender Pfeil behauptet stillschweigend, dass es keine Abhängigkeit gibt. Auch der Gegenfall kam vor: Jemand hat einen echten Fehler entdeckt, weil ein Pfeil in die falsche Richtung zeigte, ein Fehler, den der Fließtext verborgen hatte. Beides stimmt. Ein Diagramm macht Struktur sichtbar, auch falsche Struktur, und macht Auslassungen unsichtbar.
So würde ich es nutzen: Bitte um ein Diagramm in einem Textformat, das du lesen und diffen kannst (Mermaid, Graphviz, ein einfaches SVG), sieh dir das gerenderte Ergebnis an und lass das Modell darunter jede gezeichnete Beziehung als Satz auflisten. Dann lies die Liste.
Warum sollte ein LLM Output in HTML liefern?
Bret Victor hat das Ziel 2011 in „Explorable Explanations“ beschrieben: „A reactive document allows the reader to play with the author's assumptions and analyses, and see the consequences.“ Genau das bietet eine HTML-Antwort und Prosa nicht: Tabellen und Schieberegler, ausklappbare Abschnitte, kleine Simulationen. Diese Stufe mochten die Antwortenden am meisten, und Claudes Artifacts und ChatGPTs Canvas haben generierte Inhalte 2024 in eigene Arbeitsbereiche geholt.
Der beste Vorschlag im Thread, unabhängig voneinander von mehreren Leuten gemacht, war eine Variante: Bitte nicht um eine Seite, die die Antwort zeigt, sondern um eine Seite, auf der du eine Annahme ändern und zusehen kannst, was kaputtgeht. Damit werden die Annahmen der Erklärung überprüfbar. Ein Test am echten System ist das noch nicht. Wenn ein Modell einen Caching-Bug mit einer interaktiven Seite erklärt, prüft der Schalter auf der Seite das Modell des Bugs auf dieser Seite, nicht dein System; um die Diagnose zu prüfen, reproduziere sie mit dem echten Code und den echten Eingaben.
Die Kosten: Ein HTML-Artifact braucht mehr Tokens und Zeit als eine Textantwort, und es kann auf dieselbe Weise ausgefeilt und trotzdem falsch sein wie das Cheat-Sheet. Bitte um eine eigenständige Datei, deren Annahmen sichtbar auf der Seite aufgelistet sind.
Kann ein LLM ein Erklärvideo im Stil von 3Blue1Brown machen?
Zunehmend, und genau hier ist Karpathy am begeistertsten und die Beweislage am dünnsten. Ein Weg zum „3b1b style“ ist Manim, die Animations-Engine, die Grant Sanderson für 3Blue1Brown geschrieben hat (MIT-Lizenz, rund 94.500 Sterne), oder ManimCE, der besser dokumentierte Community-Fork; die Einrichtung unterscheidet sich, also sag dazu, welche Variante du willst. Ein Modell schreibt Manim-Code, der Code rendert die Animation, ein Text-to-Speech-Dienst spricht den Kommentar. In den Antworten haben Leute genau das innerhalb eines Tages gemacht: zu stochastischer Analysis, dazu, wie Zahlungen funktionieren, einmal komplett mit lokalen Tools und ohne API-Keys, also die Alternative, die Karpathy selbst erwähnt.
Hinter der Idee steht echte Forschung. TheoremExplainAgent (ACL 2025), evaluiert auf einem Benchmark mit 240 Theoremen, fand etwas Ermutigendes: Die Videos legten Fehler im Denken des Modells offen, die seine Texterklärungen verborgen hatten. Eine Animation zwingt dazu, sich darauf festzulegen, was als Nächstes passiert. Ob das verbessert, was die Zuschauer lernen, ist eine andere Frage, die die Studie nicht getestet hat.
Drei praktische Hinweise. ElevenLabs, das Karpathys Beispiel-Prompt nennt, protokolliert standardmäßig den Text, den du schickst, und das Abschalten ist ein Enterprise-Feature. Halte also private Inhalte aus gehosteter Vertonung heraus oder nimm den lokalen Weg. Hinterlege den Key in den Zugangsdaten-Einstellungen des Tools statt in einem Prompt. Und Video lässt sich ohne Transkript oder Kapitel schwerer überfliegen: In einer Studie mit 6,9 Millionen Wiedergabesitzungen über 862 edX-Videos erreichte die mediane Verweildauer ihr Maximum bei etwa sechs Minuten. Bewahre Skript, Untertitel und das Quellprojekt auf, damit die Aussagen durchsuchbar bleiben. Eine frühe Antwort hat das Risiko in einem Satz zusammengefasst: „a wrong claim narrated over a 3b1b animation is way harder to catch than a wrong sentence.“
Heißt leichter lesbarer LLM-Output auch leichter überprüfbarer Output?
Nicht von selbst. Ein klareres Format kann einen Fehler aufdecken, wie es der Pfeil und die Theorem-Videos getan haben, und es kann eine unbelegte Behauptung leichter annehmbar machen. Die nützliche Frage ist, was du mit jedem Format prüfen kannst.
Die Forschung zum zweiten Effekt lohnt sich. In einer Studie von 2024 (Si et al., NAACL) lagen rund 80 Crowdworker, die Behauptungen mithilfe der Erklärung eines LLM prüften, in 87 % der Fälle richtig, wenn die Erklärung stimmte, und in 35 %, wenn sie falsch war. Das ist weniger als die 49 %, die sie in diesen Fällen ganz ohne Belege schafften. Eine Studie auf der CHI 2021 fand, dass Erklärungen die Akzeptanz von AI-Ratschlägen erhöhten, ob der Rat nun richtig war oder nicht. Arbeiten zur Textvereinfachung (Devaraj et al., ACL 2022) fanden in vereinfachten Fassungen häufig Sachfehler und argumentierten, dass eine lesbare, aber ungenaue Fassung schlechter sein kann als gar kein Zugang. Und die Illusion der Erklärungstiefe, unsere Neigung zu überschätzen, wie gut wir Mechanismen verstehen, lässt mich aufpassen, einen sichtbaren Mechanismus nicht mit einer vollständigen Erklärung zu verwechseln.
Keine dieser Studien hat Karpathys vier Formate verglichen, also behaupte ich nicht, dass jede Stufe schwerer zu prüfen ist als die vorige. Was ich sagen würde, ist enger gefasst: Jede Stufe verlagert die Behauptungen an einen neuen Ort. In Prosa kannst du sie zitieren und durchsuchen. Ein Diagramm steckt sie in Pfeile und Lücken. Eine Seite steckt sie in Code und Layout. Ein Video steckt sie in Timing und Stimme. Die Prüfung muss ihnen dorthin folgen, und keines der vier Formate nimmt dir das ab.
Karpathys Zusammenfassung sagt, unsere Arbeit werde aufsteigen „into oversight and understanding“. Ich halte das für richtig und würde ergänzen, dass beides nicht dieselbe Tätigkeit ist. Eine Übersetzung zu verstehen ist nicht dasselbe, wie sie zu verifizieren, und das gilt für jeden Output, den du nicht selbst hättest erzeugen können.
Wie nutzt du Karpathys Techniken, ohne dich täuschen zu lassen?
Nutze alle vier Stufen; sie sind gut. Behalte auf jeder Stufe eine Sache, die du prüfen kannst.
Für Text in STE oder etwas Ähnlichem:
- Bitte um die vereinfachte Fassung und behalte das Original daneben. Vereinfachung sollte eine Ansicht sein, kein Ersatz.
- Sag dem Modell, dass es Bezeichner, Parameternamen, Fehlermeldungen und Fachbegriffe exakt so lassen soll, wie sie geschrieben sind, und jedes „wenn“, „außer“ und „nicht verifiziert“ behalten soll. Genau diese Wörter lässt ein Vereinfacher als Erstes fallen.
- Wenn der Stil wichtig ist, prüfe ihn mit einem Linter, statt dich auf das Wort des Modells zu verlassen.
Für Diagramme: Fordere ein Textformat an, sieh dir das Rendering an und lies dann einen Satz pro Kante.
Für HTML: Bitte um die Seite, auf der du eine Annahme ändern kannst, mit aufgelisteten Annahmen, und teste das echte System separat.
Für Video: Behalte das Skript als Text, lies es einmal, bevor du das Video ansiehst, und halte private Inhalte aus gehosteter Vertonung heraus.
Und für alles, auf dessen Grundlage du handeln wirst: Nimm eine tragende Behauptung und prüfe sie an der Primärquelle. So ist das Cheat-Sheet aufgeflogen. Dafür reichte ein Blick auf einen einzigen Wörterbucheintrag.
Was sagt Karpathys Post darüber, wohin sich Arbeit entwickelt?
Dass sich die knappe Fähigkeit vom Erzeugen von Output zum Beurteilen von Output verschiebt, und dass Modelle auch beim Beurteilen helfen können, indem sie Artefakte erzeugen, die es nie wert gewesen wären, von Hand gemacht zu werden. Das Wegwerf-Erklärstück, die einmalige interaktive Seite, das Video für ein Publikum aus einer einzigen Person: Das ist real und neu.
Was ich ergänzen würde, ist eine Unterscheidung, die der Post nicht ausspricht. Das Gefühl, etwas zu verstehen, ist kein Beleg dafür, dass es stimmt. Die Leiter ist sehr gut im Ersten. Das Zweite muss bewusst eingebaut werden, in welchem Format auch immer. Die meistgeteilte Zusammenfassung eines Standards für klares, eindeutiges Schreiben hat diese Woche eines der eigenen Lehrbeispiele dieses Standards umgedreht, im klarstmöglichen Layout. Ich würde die Primärquelle neben dem schönen Ding offen lassen.
