
Claude menschlich schreiben lassen: Was Claude noch verrät, ist die Geschichte, die es erfindet
In meinem Test hat Claude Sonnet 5.5 Geviertstriche und Floskeln schon vermieden, bevor ich sie verboten hatte. Stattdessen hat es acht von neun Texten mit einem Vorfall aus einem Team eröffnet, das es nicht gibt, und ein Humanizer-Durchgang hat jeden dieser Vorfälle behalten, weil sie menschlich klingen.
Inhalt
Am 23. Oktober schrieb Tim O’Reilly, er habe Claude beigebracht, menschlicher zu schreiben, „und jetzt ist es endlich gut genug, dass wir ihm eine Byline geben können!“
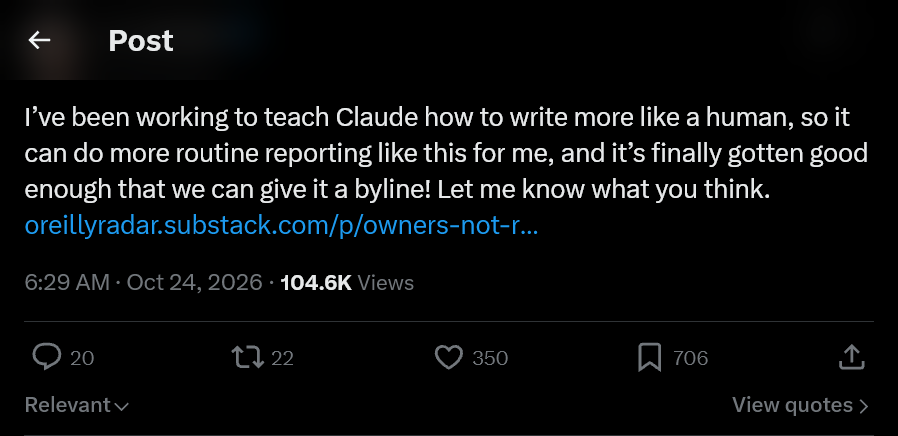
Post auf X, 23. Oktober 2026 (US-Zeit), zur Besprechung wiedergegeben.
Die Antworten teilten sich so, wie sie sich in solchen Threads immer teilen. Manchen gefiel es. Einer schrieb: „Klingt für mich nach KI.“ Ein anderer fragte, ob der Text an Pangram vorbeikäme, dem Detektor. Die nützlichste Antwort kam von jemandem, der dasselbe schon versucht hatte:
mit einer liste verbotener phrasen bin ich vielleicht bis zur hälfte gekommen, als ich das probiert hab. was immer wieder durchgerutscht ist, war der rhythmus, jeder absatz landet auf einer netten kleinen erkenntnis
Mit der ersten Hälfte hat diese Antwort recht, und ich glaube, sie irrt sich darin, was durchrutscht. Ich habe einen kleinen Test mit Claude Sonnet 5.5 gemacht: neun Generierungen desselben Einstiegsabsatzes mit drei Prompts, danach ein Durchgang eines beliebten Humanizer-Skills über jedes Ergebnis. Das Modell hat jedes Wort auf meiner Verbotsliste vermieden, bevor ich es verboten hatte. Ein Stil-Prompt hat den Rhythmus ein wenig verschoben. Und acht der neun Texte begannen mit einem Vorfall aus „unserem Team“, der nie passiert ist. Der Humanizer-Durchgang hat alle acht behalten.
Was sagt Tim O’Reillys Claude-Byline eigentlich aus?
Als Autor steht der O’Reilly-Account da, und die Seite trägt eine einzige Zeile zur Offenlegung:
Created by Claude with light editing by Tim O'Reilly
Der erste Satz des Artikels lautet: „Raffi Krikorian, CTO von Mozilla, sprach auf unserer letzten AI Codecon mit Tim O’Reilly über Open-Source-KI.“ Der Text berichtet also über ein Gespräch, an dem O’Reilly beteiligt war. Der Beitrag sagt nicht, mit welchem Material Claude gearbeitet hat, aber wer die Zusammenfassung einer Veranstaltung prüft, bei der er selbst dabei war, kann ein falsches Zitat von einem richtigen unterscheiden. Das zählt mehr als die Prosa, und deshalb kamen mehrere Antworten direkt auf die Verantwortung: Eine Byline sagt, wer für einen Sachfehler geradesteht. O’Reilly kann für diesen Text gut geradestehen. Schwieriger wird es, wenn das Modell die Fakten selbst liefern muss, und genau dort ist mein Test herausgekommen.
Warum bringt eine Verbotsliste Claude nur bis zur Hälfte?
Weil sie auf Merkmale zielt, die das getestete Modell schon abgelegt hatte, und weil ein Verbot sagt, was man nicht schreiben soll, ohne zu sagen, was stattdessen.
Wikipedias Signs of AI writing, der Leitfaden des WikiProject AI Cleanup, den blader/humanizer als seine Quelle nennt, datiert den übermäßigen Gebrauch von Geviertstrichen (Em-Dashes) inzwischen auf die Jahre 2022 bis September 2026, behandelt ihn also als historisches Merkmal, und schreibt, bei neueren Modellen habe man „immer häufiger festgestellt, dass sie fest darauf programmiert sind, überhaupt keine Em-Dashes zu verwenden“. Auch den aufgeräumten Schlussabschnitt „Fazit“ ordnet er inzwischen unter historische Muster ein. Anthropic beschreibt sein neuestes Modell aus Herstellersicht genauso. Sein Leitfaden zum Prompting von Claude Fable 5.1 sagt, die Texte dieses Modells hätten „wenige Floskeln und kaum unerklärten Jargon“, und was bleibe, sei Dichte: längere Sätze, weniger Absätze und das, was der Leitfaden „mannered prose“ nennt, also manierierte Prosa.
Anthropics allgemeiner Prompting-Leitfaden stellt den zweiten Grund in seinen Tipps zur Formatierung an den Anfang: „Sag Claude, was es tun soll, statt was es nicht tun soll.“ Eine Verbotsliste macht das Gegenteil. Das Modell behält seinen Standardstil und tauscht nur die aufgelisteten Wörter aus. Im Agentur-Thread auf r/PromptEngineering beschrieb ein Kommentator die Tretmühle: Sie haben „delve“ verboten, jetzt bekommen sie „in todays landscape“, und nächsten Monat rechnen sie mit etwas anderem.
Was passierte, als ich drei Claude-Prompts und einen Humanizer-Durchgang getestet habe?
Die verbotenen Wörter und die Geviertstriche fehlten mit und ohne Verbot, der Stil-Prompt veränderte die Schlüsse und ein wenig den Rhythmus, und ein erfundener Vorfall, erzählt aus erster Hand, überstand jeden Prompt und den Humanizer-Durchgang.
Der Aufbau: eine Aufgabe, drei Prompts, je drei Durchläufe, auf Claude Sonnet 5.5 über Claude Code 2.1.310 am 25. Oktober 2026. Jeder Durchlauf ersetzte die Standardanweisungen von Claude Code durch eine einzige neutrale Zeile, lud keine Einstellungen oder Projektdateien und hatte keine Datei- oder Web-Tools. Die Aufgabe war ein Einstieg von 300 Wörtern für einen Blogpost darüber, warum ein Engineering-Team aus fünf Leuten ein Changelog führen sollte. Prompt A war nur die Aufgabe. Prompt B ergänzte die üblichen harten Regeln: keine Geviertstriche, kein „it’s not X, it’s Y“ (es ist nicht X, es ist Y), neun verbotene Wörter (delve, landscape, crucial und sechs weitere), keine Dreiergruppen. Prompt C ergänzte stattdessen eine Stilbeschreibung (schlicht, konkret, kurze Sätze neben langen, keine Zusammenfassungszeile am Ende eines Absatzes), einen Beispielabsatz in diesem Stil und Anthropics Einzeiler gegen manierierte Prosa. Danach habe ich jeden der neun Texte in einem Durchgang durch blader/humanizer 2.5.1 geschickt, mit dessen SKILL.md als Anweisungen für das Modell, auf demselben Modell.
Die mechanischen Zählungen stammen aus diesem Skript. Die Streuung ist die Standardabweichung der Satzlänge geteilt durch den Mittelwert, ein grobes Maß dafür, wie stark der Rhythmus variiert. Die Satztrennung ist eine Heuristik über Satzzeichen, gut genug für diese Texte und nicht für den allgemeinen Gebrauch:
import re
import statistics
import sys

BANNED = ["delve", "landscape", "crucial", "pivotal", "seamless",
          "robust", "leverage", "tapestry", "foster"]
BANNED_RE = re.compile(r"\b(" + "|".join(BANNED) + r")\b", re.I)
# A sentence ends at . ! or ?, optionally followed by a closing quote,
# when the next word starts with a capital, a digit or an opening quote.
SPLIT_RE = re.compile(r"(?<=[.!?])[\"\u201d\u2019]?\s+(?=[\"\u201cA-Z0-9])")

for path in sys.argv[1:]:
    text = open(path, encoding="utf-8").read()
    sentences = [s for s in SPLIT_RE.split(text.strip()) if s.strip()]
    lengths = [len(s.split()) for s in sentences]
    spread = statistics.pstdev(lengths) / statistics.mean(lengths)
    em_dashes = text.count("\u2014")
    banned = len(BANNED_RE.findall(text))
    print(f"{path}: sentences={len(lengths)} spread={spread:.2f} "
          f"em_dashes={em_dashes} banned_words={banned}")
Die letzten drei Spalten habe ich durch Lesen gezählt: ob der Text mit einem Vorfall aus erster Hand beginnt („last month, one of our engineers…“, also „letzten Monat hat einer unserer Engineers…“), ob dieser Vorfall nach dem Humanizer-Durchgang noch da war und ob der Text damit endet, den Rest des Posts anzukündigen („In this post, I’ll cover…“, also „In diesem Post geht es um…“).
| Prompt | Geviertstriche | Verbotene Wörter | Satzstreuung, vor / nach dem Humanizer | Beginnt mit erfundenem Vorfall | Vorfall vom Humanizer behalten | Endet mit Ankündigung des Posts |
|---|---|---|---|---|---|---|
| A: nur die Aufgabe | 0 | 0 | 0,47 / 0,46 | 2 von 3 | 2 von 2 | 3 von 3 |
| B: harte Regeln | 0 | 0 | 0,48 / 0,47 | 3 von 3 | 3 von 3 | 3 von 3 |
| C: Stil und Beispiel | 0 | 0 | 0,54 / 0,53 | 3 von 3 | 3 von 3 | 1 von 3 |
Drei Durchgänge pro Prompt sind eine Demonstration, keine Messung, also achte in der Tabelle auf die Nullen und die Dreien. Prompt A hatte schon keine Geviertstriche und keine verbotenen Wörter, also hatte Prompt B bei diesen Zählungen nichts zu entfernen. Bei der Regel, die ich nicht mit dem Skript gezählt habe, ist er schlicht gescheitert: Ein B-Text enthält „you sit close together, you read each other’s pull requests, and you talk in the same chat channel every day“ (ihr sitzt nah beieinander, lest gegenseitig eure Pull Requests und redet jeden Tag im selben Chat-Channel), also eine Dreiergruppe, obwohl der Prompt genau solche Gruppen verboten hatte. Prompt C hat mehrere Dinge gleichzeitig verändert, deshalb kann ich nicht sagen, welcher Teil was bewirkt hat. Seine Texte variierten die Satzlänge etwas stärker, und zwei der drei endeten nicht mehr mit einem Wegweiser. Der Humanizer-Durchgang veränderte die Formulierungen und ließ die Streuung, wo sie war.
Und jeder Prompt erzeugte dieselbe Fiktion. Prompt A schrieb „Last month, one of our engineers spent forty minutes trying to work out why the export feature had started returning dates in UTC.“ (Letzten Monat hat einer unserer Engineers vierzig Minuten gebraucht, um herauszufinden, warum die Exportfunktion plötzlich Datumsangaben in UTC lieferte.) Prompt C, der nach konkreten Details verlangt hatte, machte die Fiktion konkreter: „We shipped 2.14.0 on a Tuesday and spent Wednesday finding out that the export endpoint now returned UTC timestamps.“ (Wir haben 2.14.0 an einem Dienstag ausgeliefert und den Mittwoch damit verbracht herauszufinden, dass der Export-Endpoint jetzt UTC-Zeitstempel lieferte.) Am Ende versprach der Text „the two times it saved us a day of work“ (die zwei Male, bei denen es uns einen Arbeitstag gespart hat). Es gibt kein Team, kein Release 2.14.0 und keinen gesparten Tag. Nach dem Humanizer-Durchgang standen beide Sätze noch da, Wort für Wort. Der eine Text ohne Vorfall, der dritte aus Prompt A, nutzte ein Szenario, das er als hypothetisch kennzeichnete („Picture a Tuesday three months from now“, stell dir einen Dienstag in drei Monaten vor), und auch dieser Text kam unverändert durch den Durchgang.
Warum ist eine erfundene Anekdote das gefährlichste Merkmal in Claudes Texten?
Weil sie menschlich klingt, sodass ein Durchgang, der nach KI-Mustern sucht, nichts zu markieren hat, und weil sie falsch ist.
Schreibratgeber sagen dir, du sollst ein konkretes Detail und eine Ich-Perspektive einbauen. Das sind gute Regeln, wenn du die Details hast. Bekommt das Modell ein Thema und keine Fakten, befolgt es dieselbe Regel, indem es das plausibelste Detail erzeugt, und das plausibelste Detail für einen Engineering-Blog ist ein Vorfall in der eigenen Firma des Autors. Mein Prompt C verlangte „a concrete detail (a version number, a date, a command)“ (ein konkretes Detail, etwa eine Versionsnummer, ein Datum, einen Befehl) und bekam eins, erfunden.
Die Dokumentation des Humanizer-Skills zeigt denselben Fehler. Der Autor eines r/ClaudeCode-Threads über Humanizer-Skills mit 623 Votes empfiehlt blader/humanizer als den besten. Der Skill weist das überarbeitende Modell an: „Use ‘I’ when it fits“ (sag „ich“, wenn es passt), und er soll Meinungen haben. Sein vollständiges Beispiel in Version 2.5.1 der SKILL.md beginnt mit einem Absatz KI-Füllstoff, der keine Studie, keine Person und keine Erfahrung aus erster Hand enthält. Die erste Fassung der Überarbeitung fügt „a 2024 study by Google“ (eine Google-Studie von 2024) hinzu, eine Entwicklerin namens Mira „at a fintech startup I interviewed“ (bei einem Fintech-Startup, mit dem ich ein Interview geführt habe) und „I have mass-accepted suggestions that compiled“ (ich habe massenhaft Vorschläge übernommen, die kompiliert haben). Der Prüfschritt des Skills merkt dann an, dass die genannten Personen und Studienzitate „wie plausible, aber erfundene Platzhalter wirken können, sofern sie nicht echt und belegt sind“, und die Endfassung streicht Mira und die Studie. Sie behält „I’ve accepted suggestions that compiled“ und „People I talk to tend to land in two camps“ (die Leute, mit denen ich rede, landen meist in zwei Lagern), also Erfahrung, die im Ausgangstext nie vorkam. Die Prüfung fängt einen erfundenen Namen ab und lässt ein erfundenes „Ich“ durch. In meinem Test ließ er jedes erfundene „Wir“ durch.
Der Wikipedia-Leitfaden warnt vor der allgemeinen Form davon: „Bitte behandelt diese Merkmale nicht bloß als die Probleme, die behoben werden müssen; das könnte die Erkennung nur schwerer machen.“ Ein Durchgang, der die Merkmale aus einem Text mit einer erfundenen Geschichte entfernt, kann nur eine flüssigere Version derselben Geschichte zurückgeben.
Solltest du Claudes Stilregeln in den Prompt schreiben oder danach einen Humanizer-Durchgang machen?
Beides, weil die zwei verschiedene Aufgaben erledigen. Der Prompt muss die Fakten und den Stil tragen; der Durchgang danach kann Formulierungen aufräumen, hat in meinem Test aber weder Abwechslung hinzugefügt noch erfundenes Material entfernt.
Diese Diskussion zieht sich durch beide Threads, die ich gelesen habe. Im r/ClaudeCode-Thread zum Humanizer fragte ein Kommentator, warum man den Skill überhaupt als Nachbearbeitung nach der Generierung nutzt: „Mach das einfach zur Vorgabe für die Generierung selbst. Du verbrauchst weniger Tokens.“ Ein anderer antwortete, Modelle seien besser im Kritisieren und Überarbeiten, und das Modell werde „so oft es kann trotzdem auf seinen Mist-Schreibstil zurückfallen“. Der Agentur-Post auf r/PromptEngineering beschreibt ein Setup aus drei Ebenen: harte Regeln, einen Stil, der auf vier Skalen bewertet wird, und eine Persona mit echten Schreibproben.
Mein Test hat diese Ansätze nicht direkt gegeneinander verglichen, aber er zeigt in eine Richtung. Die Unterschiede, die ich sehen konnte, kamen aus dem Prompt, und der Durchgang hat vor allem umformuliert. Anthropics Leitfaden setzt ebenfalls beim Prompt an. Beispiele seien „einer der zuverlässigsten Wege, Format, Ton und Struktur von Claudes Ausgabe zu steuern“, am besten in Gruppen von drei bis fünf und so unterschiedlich, dass Claude nicht das falsche Muster kopiert. Der Leitfaden sagt auch, dass der Formatierungsstil deines Prompts auf die Antwort abfärben kann. Ein Stil-Prompt, der als Aufzählungsliste formuliert ist, kann das Modell also zu Aufzählungen ziehen. Ob eine echte Probe deines eigenen Schreibens eine geschriebene Beschreibung davon schlägt, habe ich nicht getestet; mein Beispielabsatz wurde für das Experiment geschrieben.
Warum lassen wiederholte Humanizer-Durchgänge Texte mehr nach KI klingen?
Meiner Einschätzung nach, weil jeder Durchgang mittelt, und beim Mitteln verschwinden die unregelmäßigen Stellen zuerst.
Für Übersetzungen und Texte allgemein habe ich das in Eine Übersetzung lässt sich nicht durch Lesen prüfen ausgeführt: Schick einen Text durch einen Aufräum-Durchgang, dann durch noch einen, und die Durchgänge laufen auf die blasse Mitte zu statt auf deine Stimme. Die Lösung dort war, früher aufzuhören und eine einzige stimmige Überarbeitung zu machen.
blader/humanizer hat eine Version dieser Schleife schon eingebaut. Nach seiner Überarbeitung fragt es sich selbst „What makes the below so obviously AI generated?“ (Was macht den Text unten so offensichtlich KI-generiert?) und überarbeitet erneut. Einmal ausgeführt ist das eine vernünftige Prüfung. Steck den Skill in eine Schleife oder häng ihn hinter andere Aufräum-Prompts, und der Effekt summiert sich. Eine schnelle Prüfung, bevor du einen zweiten Durchgang übernimmst: Vergleich ihn per Diff mit dem ersten. Wenn der zweite Durchgang vor allem Sätze entfernt hat, die dir gefallen haben, behalte den ersten.
Kommt humanisierter Claude-Text an Pangram oder einem anderen KI-Detektor vorbei?
Niemand hat einen Test eines solchen Bearbeitungs-Skills gegen Pangram veröffentlicht, und daran vorbeizukommen ist ohnehin das falsche Ziel.
Die beste unabhängige Studie, die ich kenne, ist ein Working Paper von Brian Jabarian und Alex Imas, Artificial Writing and Automated Detection (NBER, September 2025). Sie haben Pangram, Originality.ai, GPTZero und einen Open-Source-Detektor auf RoBERTa-Basis an Texten von GPT-4.1, Claude Opus 4, Claude Sonnet 4 und Gemini 2.0 Flash verglichen. Pangram kam auf Raten falsch positiver und falsch negativer Ergebnisse nahe null, hielt gegen „Humanizer“-Tools stand und blieb als einziger der vier unter einer strengen Obergrenze von 0,5 % falsch positiven Ergebnissen, ohne an Genauigkeit zu verlieren. Der Humanizer in dieser Studie war StealthGPT, ein Paraphrasier-Produkt, das gebaut wurde, um der Erkennung zu entgehen. Das ist etwas anderes als ein Editor, der Klischees entfernt, auch wenn beide unter demselben Namen laufen. Wenn schon ein Tool, das gebaut wurde, um an Pangram vorbeizukommen, das nicht geschafft hat, würde ich von einem Klischee-Editor nichts Besseres erwarten, aber das ist meine Erwartung und kein Ergebnis.
Inzwischen gibt es eine zweite Ebene. Unterstützte Claude-Modelle versehen ihre Texte seit August mit einem Wasserzeichen, und nur Anthropic hat den Schlüssel, also kann Pangram diese Markierung nicht lesen. Was das Wasserzeichen beweisen kann und was nicht, habe ich in KI-Text-Wasserzeichen: OpenAIs textGrain, Claudes SynthID-Markierung und wer sie prüfen darf erklärt. Ob es einen Humanizer-Durchgang übersteht, habe ich nicht getestet. Stil-Detektoren haben außerdem ein dokumentiertes Bias-Problem: Eine Studie von 2023 in Patterns fand, dass sieben Detektoren Aufsätze von Menschen, die nicht Englisch als Muttersprache haben, im Schnitt in 61 % der Fälle als KI-generiert markierten. Ein Detektor-Score muss für den Detektor, das Modell und die Textsorte, um die es dir geht, validiert sein, bevor er dir in die eine oder andere Richtung viel sagt.
Wenn das Ziel ist, dass Leser dem Text vertrauen, ist ein Detektor-Score die falsche Metrik. Eine Antwort unter O’Reillys Post hat das Einfache getan: Die Person kennzeichnet ihre eigenen Posts mit „edited with the assistance of AI“ (mit Unterstützung von KI bearbeitet) oder „drafted with the assistance of AI“ (mit Unterstützung von KI entworfen).
So lässt du Claude menschlich schreiben: das Vorgehen
Gib Claude dein Material, bevor du um Prosa bittest, beschreib den Stil mit echten Proben, schließ erfundene Erfahrung aus und sag, warum, dann überarbeite einmal und prüf die Fakten.
- Gib Claude zuerst die Fakten: Notizen, ein Transkript, die Zahlen, den Vorfall so, wie er passiert ist. Kein späterer Durchgang kann sie liefern, und in meinem Test hat kein Durchgang die entfernt, die das Modell erfunden hatte.
- Verbiete erfundene Erfahrung und nenne den Grund. Anthropics Leitfaden merkt an, dass Claude aus dem Grund hinter einer Regel verallgemeinert, nicht nur aus der Regel selbst.
- Beschreib den Stil positiv und häng drei bis fünf Proben deines eigenen Schreibens an, so unterschiedlich, dass sich das Modell nicht an einer davon festbeißt.
- Für Claude Fable 5.1 schlägt Anthropic eine Zeile gegen manierierte Prosa vor. Laut Leitfaden funktioniert die Kurzform „Please remove all mannered prose.“ (Bitte entferne alle manierierte Prosa.) in der Regel. Ich hatte sie in Prompt C zusammen mit anderen Änderungen drin, deshalb kann ich nicht sagen, was sie allein bewirkt hat.
- Lass generieren, mach dann einen Überarbeitungsdurchlauf mit einem Merkmalskatalog wie blader/humanizer und prüf jede Tatsachenbehauptung gegen deine Notizen: vor allem Erfahrung aus erster Hand, aber auch Daten, Versionen, Namen und Zahlen. Was du nicht zurückverfolgen kannst, streichst du.
- Lies den Text einmal laut vor und hör auf.
Mit diesem Prompt-Block würde ich anfangen, die Schritte 1 bis 4 stecken darin:
<material>
[Your notes, transcript or data. Everything the text may state as fact.]
</material>

Write [the piece] from the material above. Use only facts that are in it.
Do not invent anecdotes, incidents, people, dates, versions, numbers or
first-person experience: the text will be published under my name, and a
made-up story is a false statement I would have to answer for. If you need
an illustration the material doesn't have, write it as an explicit
hypothetical ("imagine a team that...") and never as something that
happened. If a fact the piece needs is missing, leave a [TODO: fact]
marker instead of filling it in.

Voice: plain and specific, an engineer writing to engineers. Mix short
sentences with long ones. State an opinion and give the reason. End a
paragraph when the point is made, without a summary line.

The examples below show tone only. Do not reuse their content or their
kind of story.
<examples>
<example>[A paragraph you wrote]</example>
<example>[Another, on a different topic]</example>
<example>[A third]</example>
</examples>

Please remove all mannered prose.
Die Anweisung zum Hypothetischen steht wegen des einen Textes in meinem Test drin, der keinen Vorfall erfunden hat. Er schrieb „Picture a Tuesday three months from now“, und das liest sich gut, weil es nicht behauptet, dass etwas passiert ist. Die eigentliche Arbeit macht aber der Marker [TODO: fact]. Er verwandelt eine fehlende Tatsache in etwas, das du vor der Veröffentlichung siehst, statt in eine Release-Nummer, die nie jemand ausgeliefert hat.
01 / Diskussion
Hier gibt es keine Kommentarspalte. Diskussionen laufen auf X.
 Max Nardit@mnardit
02 / Weitere Artikel
Vox' AGENTS.md-Zeilen in 90 Claude-Code-Läufen getestet: Die Zeile, die am besten wirkte, stammte nicht von ihm
Zeile eins brachte den Agenten dazu, die Eingabeprüfung wegzulassen. Was Zeile zwei zusätzlich einbaute, verschwand, sobald Zeile eins mit in der Datei stand. „Without breaking anything“ zeigte keinen klaren Effekt über das hinaus, was ein genannter Testbefehl schon leistete. Was 90 Läufe aussagen können und was nicht, und wie du eine Zeile testest, bevor du sie behältst.
Angriffsfläche reduzieren mit Claude Code: Anthropics drei Durchläufe auf meiner eigenen Website und eine vierte Frage, die sie nicht stellen
Anthropics Skill ist nicht veröffentlicht, die Methode lässt sich an einem Nachmittag nachbauen, und das Schwierige ist die Wahl, worauf du sie richtest. Auf meiner Website war das nützlichste Ergebnis eine kaputte Verifizierungsdatei, und die Lücke, die zählte, steckte in einer Deploy-Einstellung, die meine drei Durchläufe nie angesehen haben.
Claude Auto Mode wird Standard in den Claude-Apps: was die Prüfung blockiert und was hinter den 89 % steckt
Anthropics Studie ist ehrlich, was ihren Aufbau angeht: müde Tester gegen einen einzigen eingeschleusten Befehl. Sie nennt keine False-Positive-Rate und keine Fehlerquote im echten Betrieb, und in Cloud-Sessions gibt es keinen Manual-Modus, zu dem man zurückwechseln könnte.