
Claude に人間らしい文章を書かせる方法: 最後に残る手がかりは、Claude がでっち上げる体験談
筆者のテストでは、Claude Sonnet 5.5 は、禁止しなくてもエムダッシュや定番の言い回しを使いませんでした。代わりに 9 本中 8 本の文章を存在しないチームの出来事から書き始め、humanizer のパスはそのすべてを残しました。人間が書いたように読めるからです。
目次
10月23日、Tim O'Reilly は、Claude に人間らしい文章を書くよう教えてきたと投稿し、「ついに署名を任せられるところまで良くなった!」と書きました。
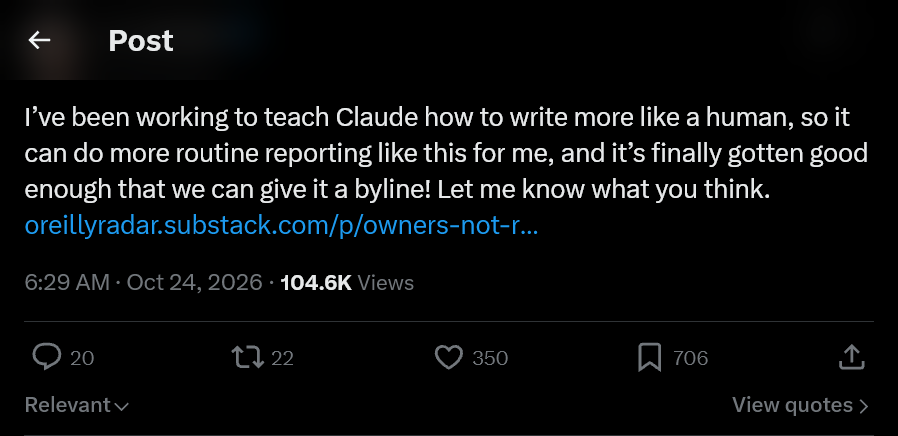
X への投稿、2026年10月23日 (米国時間)。論評のために転載しています。
返信は、この手のスレッドがいつもそうなるように割れました。気に入った読者もいました。ある人は「AI っぽく聞こえる」と書きました。別の人は、AI 検出ツールの Pangram を通るのかと尋ねました。いちばん役に立った返信は、同じことを試した人からのものでした。
自分で試したときは、禁止フレーズのリストでせいぜい半分くらいまでだった。それでも漏れ続けたのはリズムで、どの段落も小ぎれいな教訓できっちり締まっちゃう
この返信は前半については正しく、何が漏れるかについては間違っていると思います。Claude Sonnet 5.5 で小さなテストをしました。同じ冒頭段落を 3 つのプロンプトで計 9 回生成し、それぞれの結果に人気の humanizer スキルを 1 回かけています。禁止リストに載せた言葉は、禁止する前からモデルが 1 つも使っていませんでした。文体プロンプトはリズムを少し動かしました。そして 9 本中 8 本の文章が、実際には起きていない「our team」(自分たちのチーム) の出来事から始まっていました。humanizer のパスは 8 本すべてでそれを残しました。
Tim O'Reilly の Claude 署名記事には実際に何と書かれていたのか
記事は O'Reilly のアカウント名義で公開され、ページには開示が 1 行だけあります。
Created by Claude with light editing by Tim O'Reilly
記事の最初の文は「Mozilla の CTO である Raffi Krikorian が、先日開催した AI Codecon に参加し、Tim O'Reilly とオープンソース AI について語った」です。つまり、O'Reilly 自身が加わった対話の報告です。投稿は Claude が何を素材にしたのかを書いていませんが、自分がその場にいたイベントの記事をチェックする人なら、誤った引用と正しい引用を見分けられます。これは文章の出来より重要で、だからこそいくつかの返信はすぐに責任の話へ向かいました。署名とは、事実の誤りに誰が責任を負うかを示すものです。この記事なら、O'Reilly は十分に責任を負えます。モデルが事実そのものを自分で用意しなければならないとき、話は難しくなります。筆者のテストが行き着いたのはそこでした。
禁止語リストで Claude が半分までしか良くならないのはなぜか
理由は 2 つあります。テストしたモデルはその手がかりをすでに出さなくなっていました。そして禁止は何を書くなと言うだけで、代わりに何を書くかを言いません。
blader/humanizer が出典として挙げている WikiProject AI Cleanup の現場ガイド Signs of AI writing は、エムダッシュの多用を 2022年から2026年9月までの特徴として挙げ、新しいモデルについては「エムダッシュをまったく使わないようハードコードされていると判明することがますます増えている」と書いています。小ぎれいな「Conclusion」(結論) セクションも、過去のパターンに分類されました。Anthropic は最新モデルについて、反対側から同じことを述べています。Claude Fable 5.1 のプロンプトガイド によると、このモデルの文章は「定番フレーズが少なく、説明のない専門用語もほとんどない」ので、残る特徴は密度です。長い文、少ない段落の区切り、そしてガイドが mannered prose (気取った文章) と呼ぶものです。
Anthropic の 一般的なプロンプトガイド は、書式についての助言の冒頭で、この 2 つ目の理由を挙げています。「してほしくないことではなく、代わりに何をしてほしいかを Claude に伝えてください」。禁止リストはその逆です。モデルはデフォルトの文体を保ったまま、リストにある言葉だけを差し替えます。r/PromptEngineering にあるエージェンシーの投稿のスレッドで、あるコメント投稿者はこのいたちごっこをこう説明していました。「delve」(掘り下げる) を禁止したら今度は「in todays landscape」(今日の状況において) が出てくるようになり、来月はまた別の何かが出てくるだろう、と。
Claude の 3 つのプロンプトと humanizer パスを試したら何が起きたか
禁止語とエムダッシュは禁止してもしなくても出てこず、文体プロンプトは締めくくりとリズムの一部を変え、一人称ででっち上げた出来事はどのプロンプトでも、humanizer のパスを通っても残りました。
設定はこうです。1 つのタスクに 3 つのプロンプトを用意し、それぞれ 3 回ずつ、2026年10月25日に Claude Code 2.1.310 経由で Claude Sonnet 5.5 を実行しました。各実行では Claude Code のデフォルトの指示を中立的な 1 行に置き換え、設定ファイルもプロジェクトファイルも読み込まず、ファイルツールも Web ツールも使えない状態にしました。タスクは、5 人のエンジニアリングチームがなぜ changelog を付けるべきかを論じるブログ記事の書き出しを、英語で 300 語書くことです。プロンプト A はタスクだけです。プロンプト B には定番の厳格なルールを加えました。エムダッシュ禁止、「it's not X, it's Y」(X ではなく Y だ) の禁止、9 つの禁止語 (delve、landscape、crucial とほか 6 つ)、3 つ組の禁止です。プロンプト C には代わりに、文体の説明 (平易で具体的、短い文と長い文を混ぜる、段落の最後にまとめの一文を置かない)、その文体で書いた例文の段落 1 つ、そして mannered prose に対する Anthropic の 1 行の対策を加えました。そのうえで 9 本の文章をそれぞれ 1 回ずつ、同じモデルで blader/humanizer 2.5.1 に通しました。その SKILL.md をモデルへの指示として読み込んでいます。
機械的なカウントは、このスクリプトで出しています。spread (ばらつき) は文の長さの標準偏差を平均で割った値で、リズムがどれだけ変化するかの大まかな指標です。文の分割は句読点に基づくヒューリスティックで、今回の英語の文章には十分ですが、汎用には向きません。
import re
import statistics
import sys

BANNED = ["delve", "landscape", "crucial", "pivotal", "seamless",
          "robust", "leverage", "tapestry", "foster"]
BANNED_RE = re.compile(r"\b(" + "|".join(BANNED) + r")\b", re.I)
# A sentence ends at . ! or ?, optionally followed by a closing quote,
# when the next word starts with a capital, a digit or an opening quote.
SPLIT_RE = re.compile(r"(?<=[.!?])[\"\u201d\u2019]?\s+(?=[\"\u201cA-Z0-9])")

for path in sys.argv[1:]:
    text = open(path, encoding="utf-8").read()
    sentences = [s for s in SPLIT_RE.split(text.strip()) if s.strip()]
    lengths = [len(s.split()) for s in sentences]
    spread = statistics.pstdev(lengths) / statistics.mean(lengths)
    em_dashes = text.count("\u2014")
    banned = len(BANNED_RE.findall(text))
    print(f"{path}: sentences={len(lengths)} spread={spread:.2f} "
          f"em_dashes={em_dashes} banned_words={banned}")
最後の 3 列は読んで数えました。文章が一人称の出来事 (「last month, one of our engineers…」、先月、うちのエンジニアの 1 人が…) で始まるか、その出来事が humanizer のパスの後も残っていたか、そして記事の残りを予告して終わるか (「In this post, I'll cover…」、この記事では…を取り上げます) です。
| プロンプト | エムダッシュ | 禁止語 | 文の長さの spread (パス前 / パス後) | でっち上げた出来事で始まる | humanizer が出来事を残した | 記事の予告で終わる |
|---|---|---|---|---|---|---|
| A: タスクのみ | 0 | 0 | 0.47 / 0.46 | 3 本中 2 本 | 2 本中 2 本 | 3 本中 3 本 |
| B: 厳格なルール | 0 | 0 | 0.48 / 0.47 | 3 本中 3 本 | 3 本中 3 本 | 3 本中 3 本 |
| C: 文体と例文 | 0 | 0 | 0.54 / 0.53 | 3 本中 3 本 | 3 本中 3 本 | 3 本中 1 本 |
1 プロンプトあたり 3 回はデモンストレーションであって測定ではないので、表はゼロと 3 の部分に注目して読んでください。プロンプト A の時点でエムダッシュも禁止語もなかったので、これらの項目ではプロンプト B に消すものがありませんでした。スクリプトで数えなかったルールについては、B はあっさり失敗しました。B の文章の 1 つに「you sit close together, you read each other's pull requests, and you talk in the same chat channel every day」(近くに座り、互いのプルリクエストを読み、毎日同じチャットチャンネルで話す) という一文があり、3 つ組を禁止したプロンプトで 3 つ組が出ています。プロンプト C は複数のことを一度に変えたので、どの部分が何をしたのかは言えません。C の文章は文の長さが少しだけ多様になり、3 本中 2 本は記事の予告で締めくくるのをやめました。humanizer のパスは言い回しを変えましたが、spread はそのままでした。
そして、どのプロンプトも同じ種類の作り話を生みました。プロンプト A は「Last month, one of our engineers spent forty minutes trying to work out why the export feature had started returning dates in UTC.」(先月、うちのエンジニアの 1 人が、エクスポート機能がなぜ UTC で日付を返すようになったのかを突き止めるのに 40 分を費やした) と書きました。具体的なディテールを求めたプロンプト C は、作り話をより具体的にしました。「We shipped 2.14.0 on a Tuesday and spent Wednesday finding out that the export endpoint now returned UTC timestamps.」(火曜日に 2.14.0 をリリースし、水曜日はエクスポートのエンドポイントが UTC のタイムスタンプを返すようになったことの調査に費やした)。そして最後に「the two times it saved us a day of work」(それのおかげで 1 日分の作業が省けた 2 回の話) を約束しました。チームも、リリース 2.14.0 も、省けた 1 日も存在しません。humanizer のパスの後も、両方の文は一字一句そのまま残っていました。出来事のない唯一の文章、つまりプロンプト A の 3 本目は、仮定だと明示したシナリオ (「Picture a Tuesday three months from now」、3 か月後のある火曜日を想像してください) を使っていて、これもパスを無傷で通り抜けました。
でっち上げの体験談が Claude の文章でいちばん危険な手がかりなのはなぜか
人間が書いたように読めるので AI のパターンを探すパスには指摘するものがなく、しかも中身は事実ではないからです。
文章術の助言は、具体的なディテールと一人称の視点を加えろと言います。ディテールを持っているなら、良いルールです。トピックだけ与えられて事実がない場合、モデルは同じルールに従って、最ももっともらしいディテールを作り出します。そしてエンジニアリングブログにとって最ももっともらしいディテールは、書き手自身の会社で起きた出来事です。筆者のプロンプト C は「a concrete detail (a version number, a date, a command)」(具体的なディテール:バージョン番号、日付、コマンド) を求め、そのとおりのものを受け取りました。ただし作り話です。
humanizer スキル自身のドキュメントにも、同じ失敗が表れています。humanizer スキルについての r/ClaudeCode のスレッド (623 票) の投稿者は、いちばん良いものとして blader/humanizer を勧めています。このスキルは編集者に「Use 'I' when it fits」(合うときは「I」を使う) よう指示し、意見を持つよう求めます。SKILL.md のバージョン 2.5.1 にある通しの作例は、AI が書いた中身のない段落から始まります。そこには研究も人物も一人称の経験も含まれていません。書き直しの下書きは「a 2024 study by Google」(Google の2024年の研究)、「at a fintech startup I interviewed」(私が取材したフィンテックのスタートアップの) Mira というエンジニア、そして「I have mass-accepted suggestions that compiled」(コンパイルが通った提案をまとめて受け入れたことがある) を付け加えます。続いてスキルの監査ステップが、名前の出た人物や研究の引用は「実在して出典があるのでない限り、もっともらしいが作り物のプレースホルダーのように読めることがある」と指摘し、最終版では Mira と研究が削られます。ところが「I've accepted suggestions that compiled」(コンパイルが通った提案を受け入れてきた) と「People I talk to tend to land in two camps」(話を聞く人たちは 2 つの陣営に分かれがちだ) は残ります。どちらも入力にはなかった経験です。つまり監査は、でっち上げの名前は捕まえても、でっち上げの「I」は通してしまいます。筆者の実行では、でっち上げの「we」がすべて通りました。
Wikipedia のガイドは、この問題の一般的な形について警告しています。「これらの兆候を、直すべき問題としてだけ扱わないでください。それは検出を難しくするだけかもしれません」。でっち上げの話を含む文章から手がかりを取り除くパスは、同じ話をより流暢にしたものしか返せません。
Claude の文体ルールはプロンプトに入れるべきか、それとも後から humanizer パスをかけるべきか
両方です。役割が違うからです。事実と文体はプロンプトで渡さなければなりません。後からのパスは言い回しを整えられますが、筆者の実行では多様さを加えることも、でっち上げを取り除くこともしませんでした。
この議論は、読んだ 2 つのスレッドの両方に出てきます。r/ClaudeCode の humanizer スレッドでは、あるコメント投稿者が、そもそもなぜスキルを生成後の編集として使うのかと問いました。「生成そのものの制約にすればいい。トークンも少なくて済む」。別の人は、モデルは批評や編集のほうが得意で、しかも「何をしようと、できる限り自分のひどい文体に戻ろうとする」と答えました。r/PromptEngineering のエージェンシーの投稿は、3 層構成を報告しています。厳格なルール、4 つの尺度で評価する文体、そして実際の文章サンプルを持たせたペルソナです。
筆者のテストはこれらのアプローチを直接比較していませんが、結果はプロンプト側を指しています。見えた違いはプロンプトから来ていて、パスはほとんど言い換えただけでした。どこに労力をかけるべきかについては、Anthropic のガイダンスも同じ考えです。例は「Claude の出力の形式、トーン、構造を方向づける最も信頼できる方法の 1 つ」で、3 から 5 個のセットにし、Claude が間違ったパターンを真似しない程度に多様にするのが最善とされています。ガイドはまた、プロンプトの書式スタイルが応答に持ち越されることがあるとも述べています。つまり箇条書きのポリシーとして書いた文体プロンプトは、モデルを箇条書きに引き寄せかねません。自分の文章の実際のサンプルが、それを言葉で説明したものに勝るかどうかはテストしていません。筆者の例文の段落は、この実験のために書いたものです。
humanizer のパスを繰り返すと文章がかえって AI っぽくなるのはなぜか
筆者の判断では、パスのたびに平均化が起き、平均化はまず不規則な部分から削っていくからです。
翻訳と文章全般については 読むだけでは翻訳を検証できない で同じ主張をしました。文章をクリーンアップのパスに 1 回かけ、さらにもう 1 回かけると、パスはあなたの声ではなく無難な中間に収束していきます。そこでの対策は、早めに止めて、一貫した編集を 1 回だけすることでした。
blader/humanizer には、このループの一種が組み込まれています。書き直しの後、スキルは自分に「What makes the below so obviously AI generated?」(以下の文章がこれほど明らかに AI 生成だとわかるのはなぜか) と問い、もう一度書き直します。1 回だけなら妥当な監査です。スキルをループに入れたり、他のクリーンアップ用プロンプトの後につないだりすると、編集を重ねがけしていることになります。2 回目のパスを受け入れる前の簡単なチェックとして、1 回目との diff を取ってください。2 回目のパスが主に気に入っていた文を削っているなら、1 回目を残してください。
humanizer をかけた Claude の文章は Pangram などの AI 検出ツールを通るか
このような編集スキルを Pangram に対してテストした結果を公開した人はいませんし、そもそも通過を目標にするのが間違っています。
筆者が知る中で最も良い独立した研究は、Brian Jabarian と Alex Imas によるワーキングペーパー Artificial Writing and Automated Detection (NBER、2025年9月) です。Pangram、Originality.ai、GPTZero、オープンソースの RoBERTa 検出器を、GPT-4.1、Claude Opus 4、Claude Sonnet 4、Gemini 2.0 Flash の文章で比較しています。Pangram は偽陽性率と偽陰性率がほぼゼロで、「humanizer」ツールにも耐えました。偽陽性 0.5% という厳しい上限の下で精度を落とさなかったのも、4 つのうち Pangram だけでした。この研究の humanizer は StealthGPT で、検出を回避するために作られた言い換え製品です。同じ名前で呼ばれていても、決まり文句を取り除く編集ツールとは別物です。Pangram を突破するために作られたツールが突破できなかったのなら、決まり文句の編集ツールがそれよりうまくいくとは思いませんが、それは筆者の予想であって結果ではありません。
いまはもう 1 つの層があります。透かしに対応した Claude モデルは 8 月以降、生成する文章に透かしを入れていて、鍵を持っているのは Anthropic だけなので、Pangram はその透かしを読めません。透かしが何を証明でき、何を証明できないかは AI 文章の電子透かし: OpenAI の textGrain、Claude の SynthID 方式の透かし、そして誰が確かめられるのか で整理しました。透かしが humanizer のパスを経ても残るかどうかは、テストしていません。スタイルを見る検出ツールには、研究で確認されたバイアスの問題もあります。Patterns 誌に掲載された 2023年の研究では、7 つの検出ツールが、英語を母語としない人のエッセイを平均 61% の割合で AI が書いたものと判定しました。検出スコアは、自分が対象とする検出ツール、モデル、文章の種類について検証してからでないと、どちらの方向にもたいしたことを教えてくれません。
目標が読者に文章を信頼してもらうことなら、検出スコアは間違った指標です。O'Reilly の投稿への返信の 1 つは、シンプルなことをしていました。その書き手は、自分の投稿に「edited with the assistance of AI」(AI の支援を受けて編集) や「drafted with the assistance of AI」(AI の支援を受けて下書き) というラベルを付けています。
Claude に人間らしい文章を書かせる方法: 手順
文章を頼む前に素材を Claude に渡し、実際のサンプルで文体を説明し、でっち上げの経験を理由とともに禁止し、そのうえで編集は 1 回にとどめて事実を確認します。
- まず事実を Claude に渡します。メモ、書き起こし、数字、実際に起きたとおりの出来事です。後からのパスではこれを補えませんし、筆者のテストでは、モデルがでっち上げたものを取り除いたパスはありませんでした。
- でっち上げの経験を禁止し、その理由を伝えます。Anthropic のガイドによると、Claude はルールそのものだけでなく、ルールの背後にある理由からも一般化します。
- 文体は肯定的な言葉で説明し、自分の文章のサンプルを 3 から 5 個添えます。モデルがどれか 1 つに引きずられない程度に多様なものを選んでください。
- Claude Fable 5.1 については、Anthropic は mannered prose を抑える 1 行を勧めています。ガイドによれば、短い形の「Please remove all mannered prose.」(気取った文章をすべて取り除いてください) が効くことが多いそうです。筆者はこれを他の変更と一緒にプロンプト C に入れたので、単独での効果はわかりません。
- 生成したら、blader/humanizer のような手がかりカタログで編集パスを 1 回かけ、事実に関する記述をすべてメモと照合します。一人称の経験を最優先に、日付、バージョン、名前、数字も確認します。たどれないものは削ります。
- 一度声に出して読み、そこでやめます。
筆者ならここから始める、というプロンプトのブロックです。手順 1 から 4 を含んでいます。
<material>
[Your notes, transcript or data. Everything the text may state as fact.]
</material>

Write [the piece] from the material above. Use only facts that are in it.
Do not invent anecdotes, incidents, people, dates, versions, numbers or
first-person experience: the text will be published under my name, and a
made-up story is a false statement I would have to answer for. If you need
an illustration the material doesn't have, write it as an explicit
hypothetical ("imagine a team that...") and never as something that
happened. If a fact the piece needs is missing, leave a [TODO: fact]
marker instead of filling it in.

Voice: plain and specific, an engineer writing to engineers. Mix short
sentences with long ones. State an opinion and give the reason. End a
paragraph when the point is made, without a summary line.

The examples below show tone only. Do not reuse their content or their
kind of story.
<examples>
<example>[A paragraph you wrote]</example>
<example>[Another, on a different topic]</example>
<example>[A third]</example>
</examples>

Please remove all mannered prose.
仮定として書くよう指示しているのは、筆者の実行で出来事をでっち上げなかった文章が 1 本だけあったからです。その文章は「Picture a Tuesday three months from now」と書いていて、何かが起きたとは主張していないので、問題なく読めます。とはいえ、実際に効くのは [TODO: fact] マーカーのほうです。欠けている事実を、誰もリリースしていないリリース番号として紛れ込ませるのではなく、公開前に目に入るものに変えてくれます。
01 / ディスカッション
コメント欄はありません。議論は X で行っています。
 Max Nardit@mnardit
02 / ほかの記事
Vox の AGENTS.md の行を Claude Code で 90 回試した: いちばん効いた行は彼のものではなかった
1 行目を入れるとエージェントは入力チェックを省きました。2 行目が足した要素は、1 行目と同じファイルに並ぶと消えました。「without breaking anything」は、テストコマンドを書いた行がすでに果たしていた以上の効果をはっきりとは示しませんでした。90 回の実行で言えること、言えないこと、そして行を残す前に試す方法。
Claude Code によるアタックサーフェス削減: Anthropic の 3 つのパスを自分のサイトで試し、Anthropic が問わない 4 つ目の問いを加える
Anthropic のスキルはまだ公開されていませんが、手法は半日あれば再構築できます。難しいのは、どこに向けるかの選択です。今回いちばん役に立った発見は壊れていた検証ファイルで、本当に問題だった露出は、3 つのパスが一度も開かなかったデプロイ設定の中にありました。
Claude アプリで auto mode が標準に: チェックが止めるもの、89% の調査が測ったもの
Anthropic の調査は、その設計については正直です。疲れたテスターに、仕込んだ危険なコマンドを 1 つ見せただけです。誤検知率も実運用での見逃し率も示しておらず、クラウドセッションには戻る先の Manual モードがありません。